Masterarbeit über Interpretierbare
Erkennung und Inferenz
der Offenlegung personenbezogener
Daten in sozialen Medien
Masterarbeit über Interpretierbare
Erkennung und Inferenz
der Offenlegung personenbezogener
Daten in sozialen Medien
Masterarbeit über Interpretierbare
Erkennung und Inferenz
der Offenlegung personenbezogener
Daten in sozialen Medien
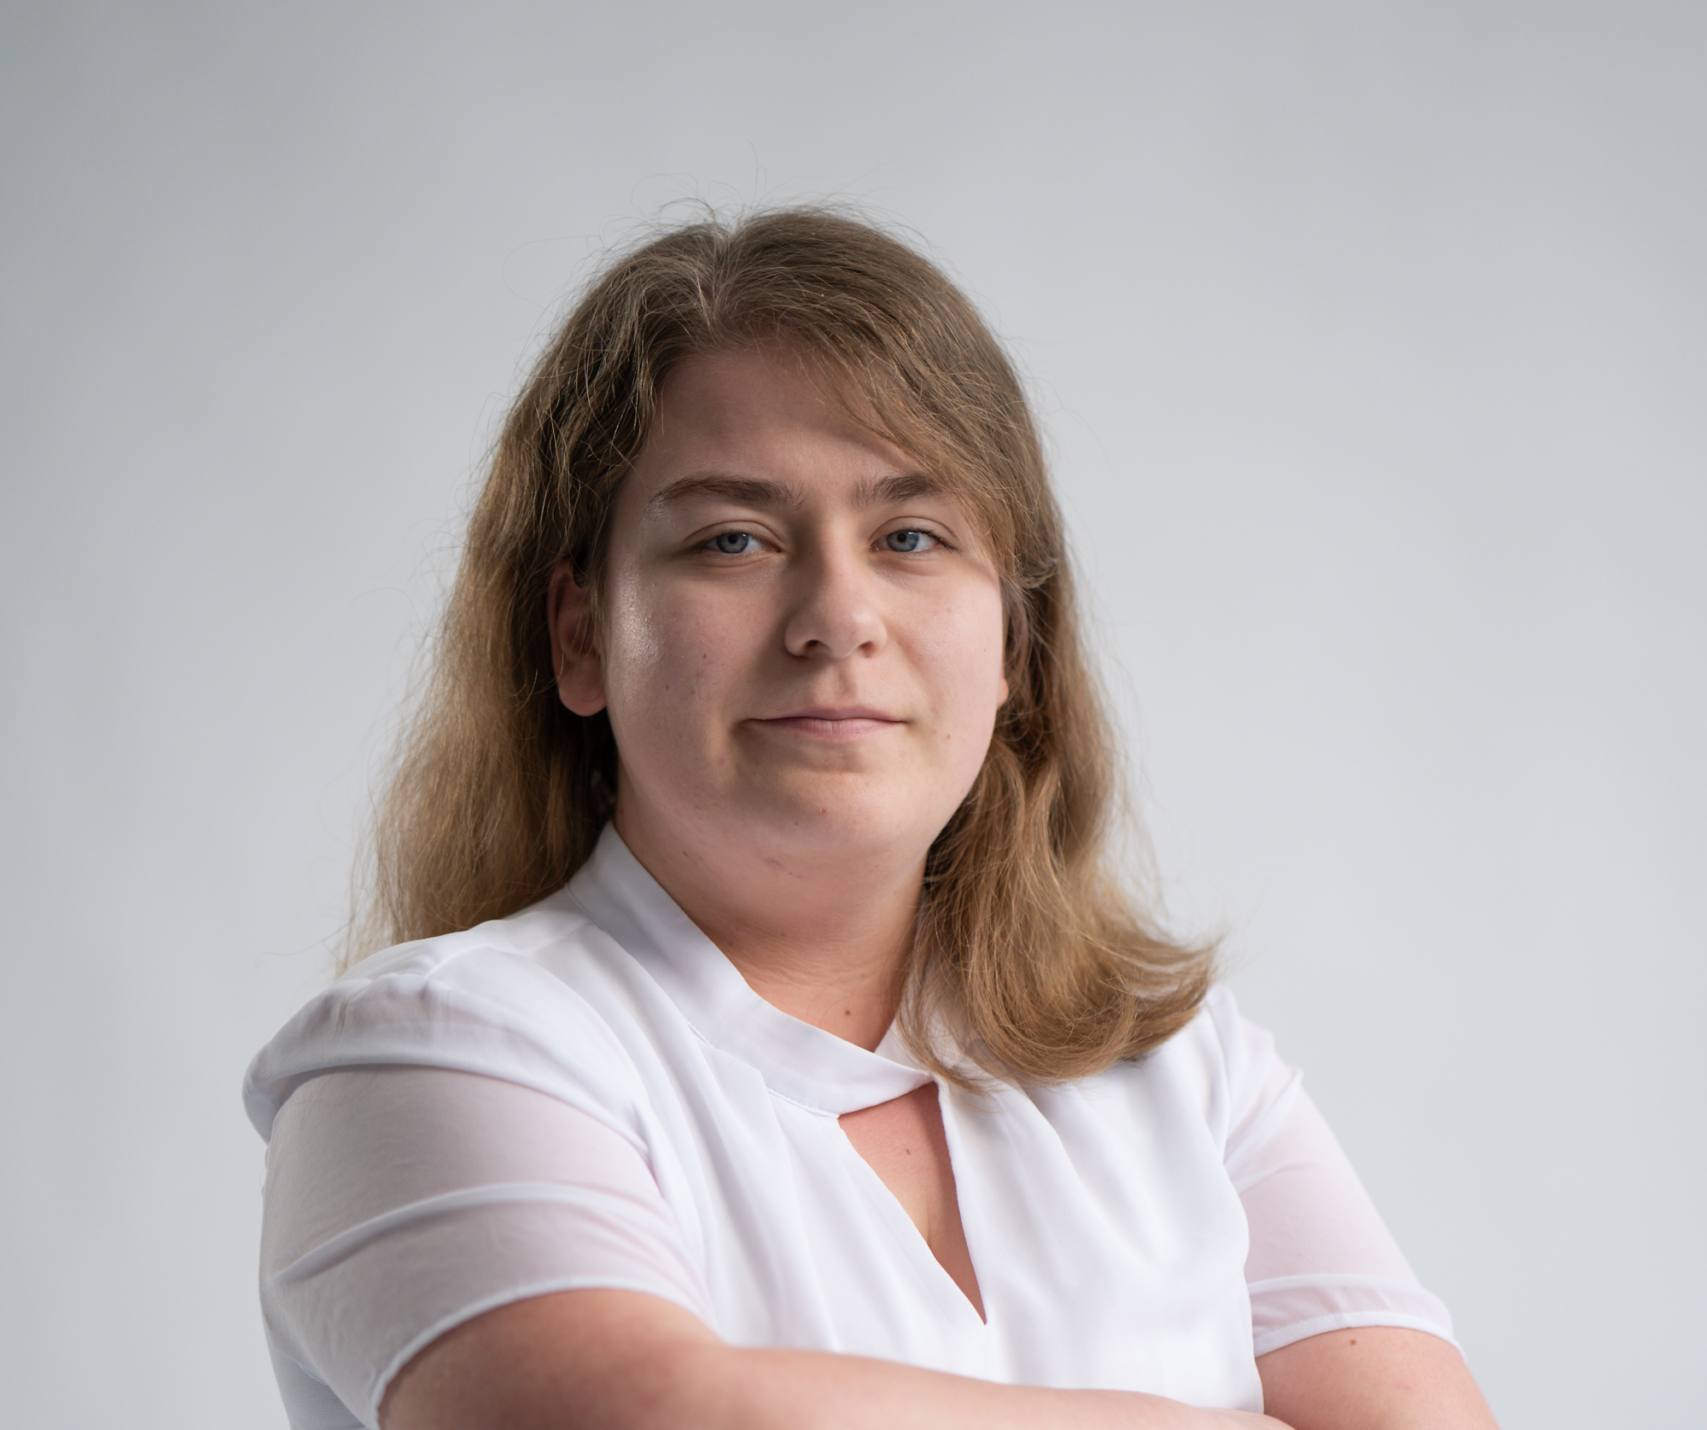
Yvonne Marneth studierte Software Engineering im Master und schrieb ihre Masterarbeit mit dem Titel „Interpretable Detection and Inference of Personal Data Exposure on Social Media“. Betreut wurde sie dabei von DI (FH) Stephan Leitner seitens der Firma und von FH-Prof. PD DI Dr. Stephan Winkler seitens der FH.
Yvonne: Kurz zusammengefasst beschäftigt sich meine Masterarbeit mit sensiblen Informationen, die Social-Media-Nutzer bewusst oder unbewusst in ihren Beiträgen veröffentlichen und welche durch den Einsatz von automatisierten Analysemethoden durch Dritte extrahiert werden können. Besonders durch moderne KI-gestützte Methoden, die zum Beispiel Large-Language-Modelle einsetzen um große Datenmengen zu analysieren und zu interpretieren, sind die ursprünglichen Quellen einzelner Informationen oft nicht mehr nachvollziehbar. Das entwickelte System betrachtet die öffentlichen Beiträge einer Person über mehrere Plattformen hinweg, um die sensiblen Attribute zu finden, zu interpretieren und für Nutzer in einer Beweiskette sichtbar zu machen.
Begonnen habe ich mit einer Recherche zu bestehenden Ansätzen zu Privacy-Exposure-Analysen, welche aber meist nur einzelne Aspekte, wie zum Beispiel Detektion, Inferenz oder Interpretierbarkeit, isoliert betrachten und selten durchgehend nachvollziehbare, belegbare Ergebnisse liefern. Darauf aufbauend habe ich eine modulare Pipeline für deutschsprachige Social-Media-Profile entwickelt: Öffentliche Beiträge eines angefragten Profils werden gesammelt, eine vortrainierte Named-Entity-Recognition-Komponente erkennt und kategorisiert darin potenzielle persönliche Informationen, und ein LLM-basierter Reasoning-Schritt kombiniert diese Indizien zu konkreten sensiblen Attributen. Dabei wird jeweils eine Begründung, verwendete Indizien und deren Quell-Beiträge inkludiert. Die NER-Komponente habe ich quantitativ über Precision, Recall und F1-Score evaluiert, die Reasoning-Komponente zusätzlich qualitativ an realen Profilen getestet.
Yvonne: Für viele Menschen, die Social Media täglich nutzen, ist es schwierig oder unmöglich abzuschätzen, welche Informationen Dritte aus den von ihnen veröffentlichten Inhalten extrahieren können. Durch die Entwicklung von Sprachmodellen, die auch natürliche Sprache verarbeiten und Kontexte durch vortrainiertes Wissen erkennen können, wird diese Herausforderung immer größer. Die größte Herausforderung in dieser Problemstellung war es, eine geeignete Datenbasis für die trainierten Modelle aufzubauen. Social-Media-Beiträge bestehen zu einem großen Teil aus Umgangssprache, Abkürzungen, Referenzen und Dialekt. Bei deutschen Inhalten kommt es dabei auch noch besonders häufig vor, dass Deutsch mit anderen Sprachen vermischt wird, zum Beispiel durch Anglizismen. All diese Fälle müssen in der Datenbasis abgedeckt sein.
DI(FH) Stephan Leitner: Soziale Medien sind für viele Menschen selbstverständlicher Teil des Alltags. Dabei geben Nutzerinnen und Nutzer oft mehr preis, als ihnen bewusst ist: Hinweise auf Arbeitgeber, Wohnort oder Familie sind öffentlich einsehbar und können von Dritten gezielt ausgewertet werden. Problematisch ist weniger der einzelne Beitrag als die Summe vieler scheinbar harmloser Informationen, aus der sich etwa Gewohnheiten oder politische Einstellungen ableiten lassen. Für Unternehmen ist das ein handfestes Sicherheitsrisiko. Angreifer nutzen öffentlich verfügbare Informationen über Mitarbeiterinnen und Mitarbeiter, um täuschend echte Phishing-Nachrichten zu verfassen oder sich beim sogenannten CEO-Fraud als Führungskraft auszugeben. IT-Sicherheitsabteilungen wollen daher verstehen, welche Angriffsfläche die Social-Media-Profile der eigenen Belegschaft bieten. Relevant ist das Thema auch für Banken und Versicherungen im Kampf gegen Identitätsdiebstahl sowie für Datenschutzbeauftragte, die verhindern müssen, dass über Unternehmenskanäle unbeabsichtigt personenbezogene Daten veröffentlicht werden.
Die Herausforderung liegt zunächst darin, dass personenbezogene Daten in Social-Media-Beiträgen selten klar strukturiert vorliegen, sondern sich in Alltagssprache, Abkürzungen oder Dialekt verstecken. Noch schwieriger ist es, aus vielen verstreuten Einzelinformationen jene Schlüsse zu ziehen, die auch ein Angreifer ziehen würde. Dazu kommt ein grundlegendes Dilemma: Für das Training eines solchen Systems bräuchte man echte personenbezogene Daten, die aus Datenschutzgründen aber gerade nicht frei verwendet werden dürfen. Künstlich erzeugte Trainingsdaten sind ein Ausweg, doch damit trainierte Modelle schneiden bei echten Beiträgen oft deutlich schlechter ab. Für den praktischen Einsatz ist zudem entscheidend, dass jede Schlussfolgerung nachvollziehbar begründet und bis zu den ursprünglichen Beiträgen zurückverfolgt werden kann. Nur so können Fachleute die Ergebnisse prüfen und Fehlschlüsse der KI erkennen.
DI(FH) Stephan Leitner: Im Rahmen ihrer Masterarbeit hat Frau Marneth gezeigt, dass sie ein vielschichtiges und gesellschaftlich wie wirtschaftlich relevantes Thema eigenständig strukturieren und technisch umsetzen kann. Anstatt Erkennung, Ableitung und Nachvollziehbarkeit getrennt zu betrachten, hat sie diese Aspekte in einer modularen, mehrstufigen Pipeline vereint. Dafür war ein breites Spektrum an Kompetenzen nötig: von der Sammlung und Aufbereitung öffentlicher Social-Media-Daten über das Training von Modellen zur Erkennung personenbezogener Daten bis hin zum gezielten Einsatz großer Sprachmodelle für die Ableitung sensibler Informationen. Bemerkenswert ist auch, wie sie mit dem Mangel an verwendbaren echten Trainingsdaten umgegangen ist und mit synthetischen sowie kombinierten Trainingsstrategien nach Lösungen gesucht hat.
Yvonne: Als ich mit dem Masterstudium begonnen habe, war ich bereits einige Jahre seit meinem Bachelor-Abschluss bei der RISC Software GmbH angestellt. Mein Vorhaben, das Masterstudium zu absolvieren und parallel weiter zu arbeiten, wurde von Anfang an durch die Firma unterstützt. Auch bei der Auswahl eines passenden Themas innerhalb der Firma hat sich diese Unterstützung gezeigt, ebenso wie durch punktuelle Reviews mit fachlichen Experten im Unternehmen, die mir immer wertvolles Feedback zu meinen Ansätzen gegeben haben. Prof. Winkler hat es mir innerhalb seiner Betreuung ermöglicht, eigenverantwortlich an meinen Lösungen zu arbeiten, und hat mich zusätzlich durch regelmäßige strategische Besprechungen unterstützt, in denen wir gemeinsam Schwächen in den bisherigen Ansätzen identifizierten und bei Bedarf den Kurs korrigierten. Dieser fachliche Austausch war für den Fortschritt der Arbeit oft entscheidend, und die Mischung aus Selbstständigkeit und gezieltem Feedback habe ich als sehr wertvoll empfunden.
Yvonne: Nachdem ich einige Jahre in der klassischen Webentwicklung gearbeitet habe, hat mir die Masterarbeit ein neues Themenfeld in Form von NLP-Anwendungen und KI-gestützten Service-Architekturen eröffnet. Ich hoffe, dass ich dieses Wissen in Zukunft in meine tägliche Arbeit integrieren kann, um weiter effiziente Lösungen für unsere Partner und Partnerinnen zu gestalten. Ich könnte mir auch vorstellen, in den nächsten Jahren einen PhD in diesem Bereich anzustreben.
Wir haben deine Unterlagen erhalten und sehen uns deine Bewerbung in Ruhe an.
Sobald wir eine Rückmeldung für dich haben oder noch etwas benötigen, melden wir uns bei dir.
Danke für dein Interesse – wir freuen uns darauf, mehr über dich zu erfahren!
In der Zwischenzeit kannst du dir die Wartezeit gerne versüßen und noch ein bisschen mehr über uns erfahren 🙂